Knowledge Hub 写到现在,差不多已经八九个月了。
公司里现在运行着一个版本,API、Chat 和 Workspace 都有人在用。入口不多,流量也不大,平时基本不用我操心。
这个项目从想法、设计、开发到部署和维护,基本都是我一个人在负责。能一路做完并跑起来,已经挺有成就感了。
先把仓库收拾一下
前段时间本来准备给一些昂贵接口加上 Limit,做着做着却先把注意力放到了仓库本身。
KH 写了这么久,功能一直在加,很多历史内容也跟着留了下来。有些是旧方案,有些是临时调试代码,还有不少文档记录着已经结束的阶段。
检索这里就是一个很直接的例子。同一个 HandleRetrieve,一度同时有 runtime 和 service 两套实现。顺着当前调用链看,真正工作的只有一套,另一套属于前一个阶段留下来的兼容代码。
它们放在仓库里不会报错,甚至还显得挺完整。等下一次维护时,还是得重新确认一遍哪个在用、哪个能删。类似的内容多了,理解代码的时间会越来越长。
文档也一样。仓库里积累了大量 Phase 记录、旧设计稿、执行报告和临时说明,其中一些描述的接口和模块早就不存在了。这些内容不会让编译失败,却会影响维护时的判断。现在又经常让 AI 参与代码分析,它读到一份写得很完整的旧方案,很可能会把历史当成当前事实。
所以这次清理得比较彻底。
最后那次提交改了 559 个文件,删掉了十万多行。大部分来自过时文档、旧构建产物和已经不在调用链上的代码。删多少行没有什么意义,这次只认一个标准:留在 main 里的内容仍然服务当前系统,文档也要能解释当前系统。
清理结束前,我还把远端和本地分支重新检查了一遍。真正需要继续发展的功能都已经进入 main,剩下的是被新版实现取代的旧分支,以及一些拆仓或备份留下来的历史。
这次主要是和 Codex 一起做的
顺便聊一下最近在用的开发工具。之前我主要用 Claude Code,前几个月开始逐步换回 Codex。KH 这轮重构和清理基本都是用 Codex 完成的,最近几个月的日常开发也主要在用 Codex。
其实 OpenAI 刚推出 Codex、还只有云端版本的时候,我就第一时间体验过。不过早期 Codex 最大的问题就是慢。GPT-4 阶段已经明显慢于 Claude 的模型,切到 GPT-5 后速度更是慢得离谱。一个任务经常要等很久,那阵子很多人都在吐槽,试过几次后就不愿意再用,我也没有在那个阶段把主力工具换过来。
虽然慢,我还是断断续续拿它做过不少真实任务。下面两张就是早期云端版留下来的记录。
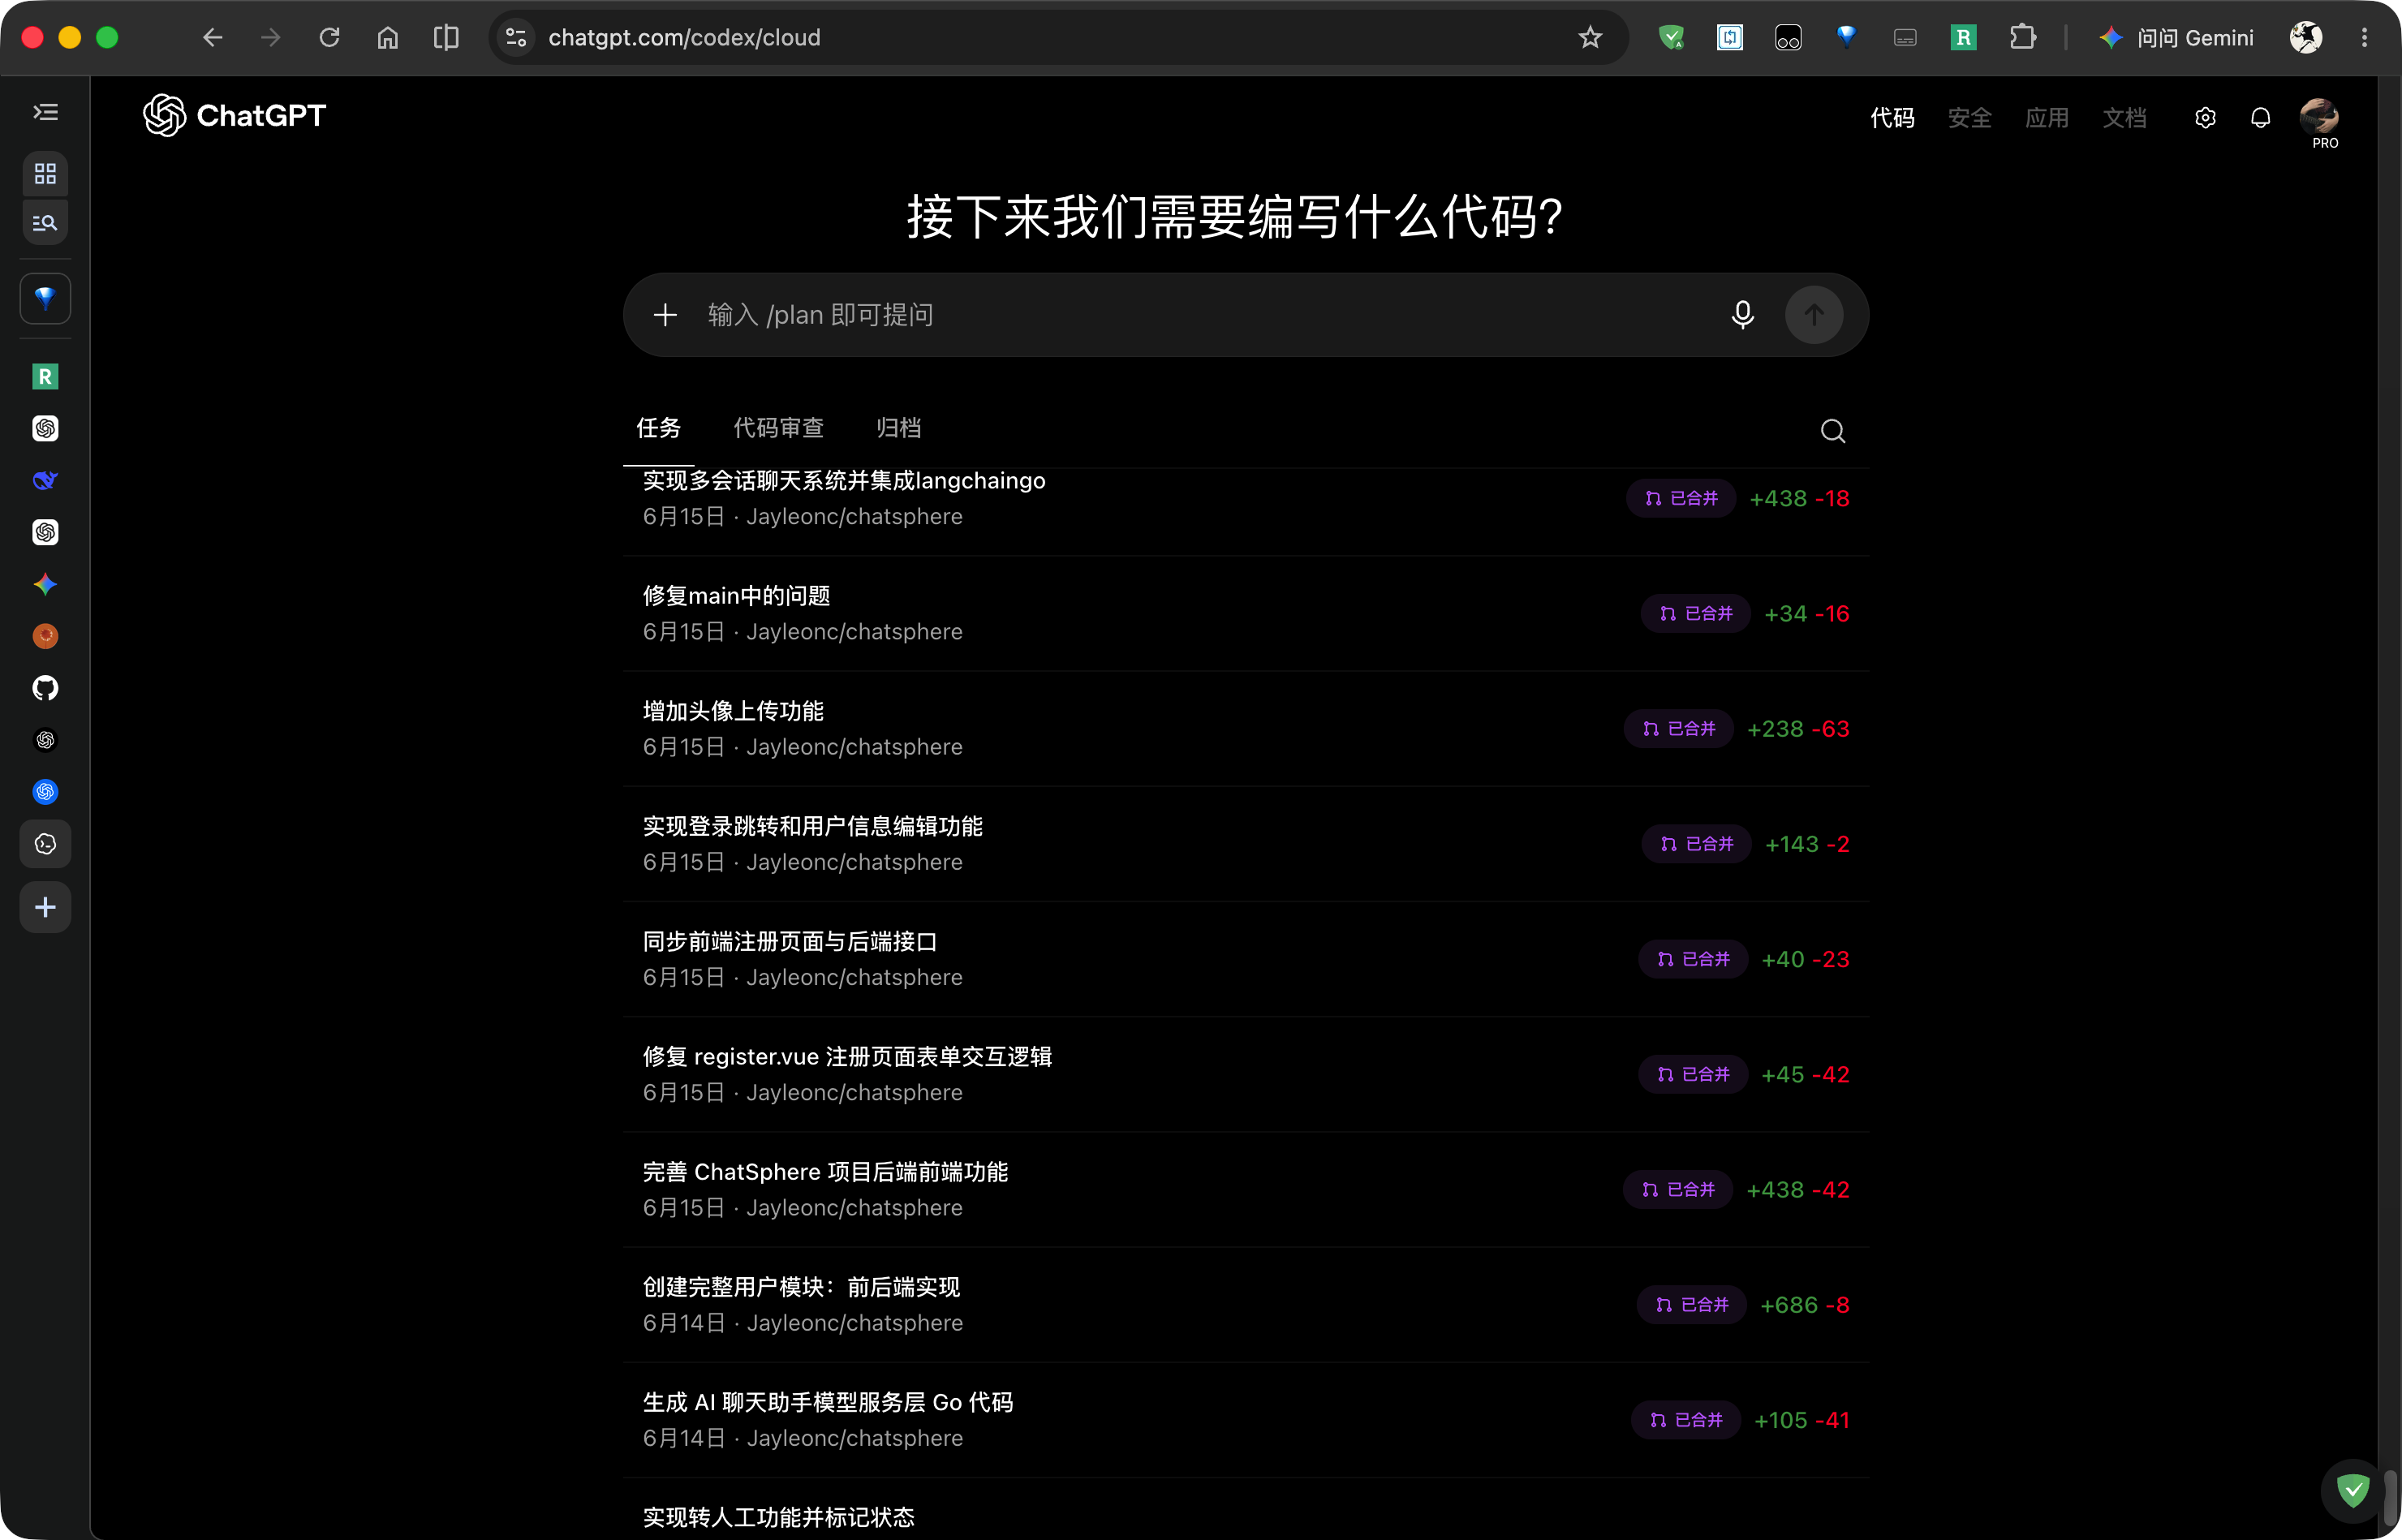
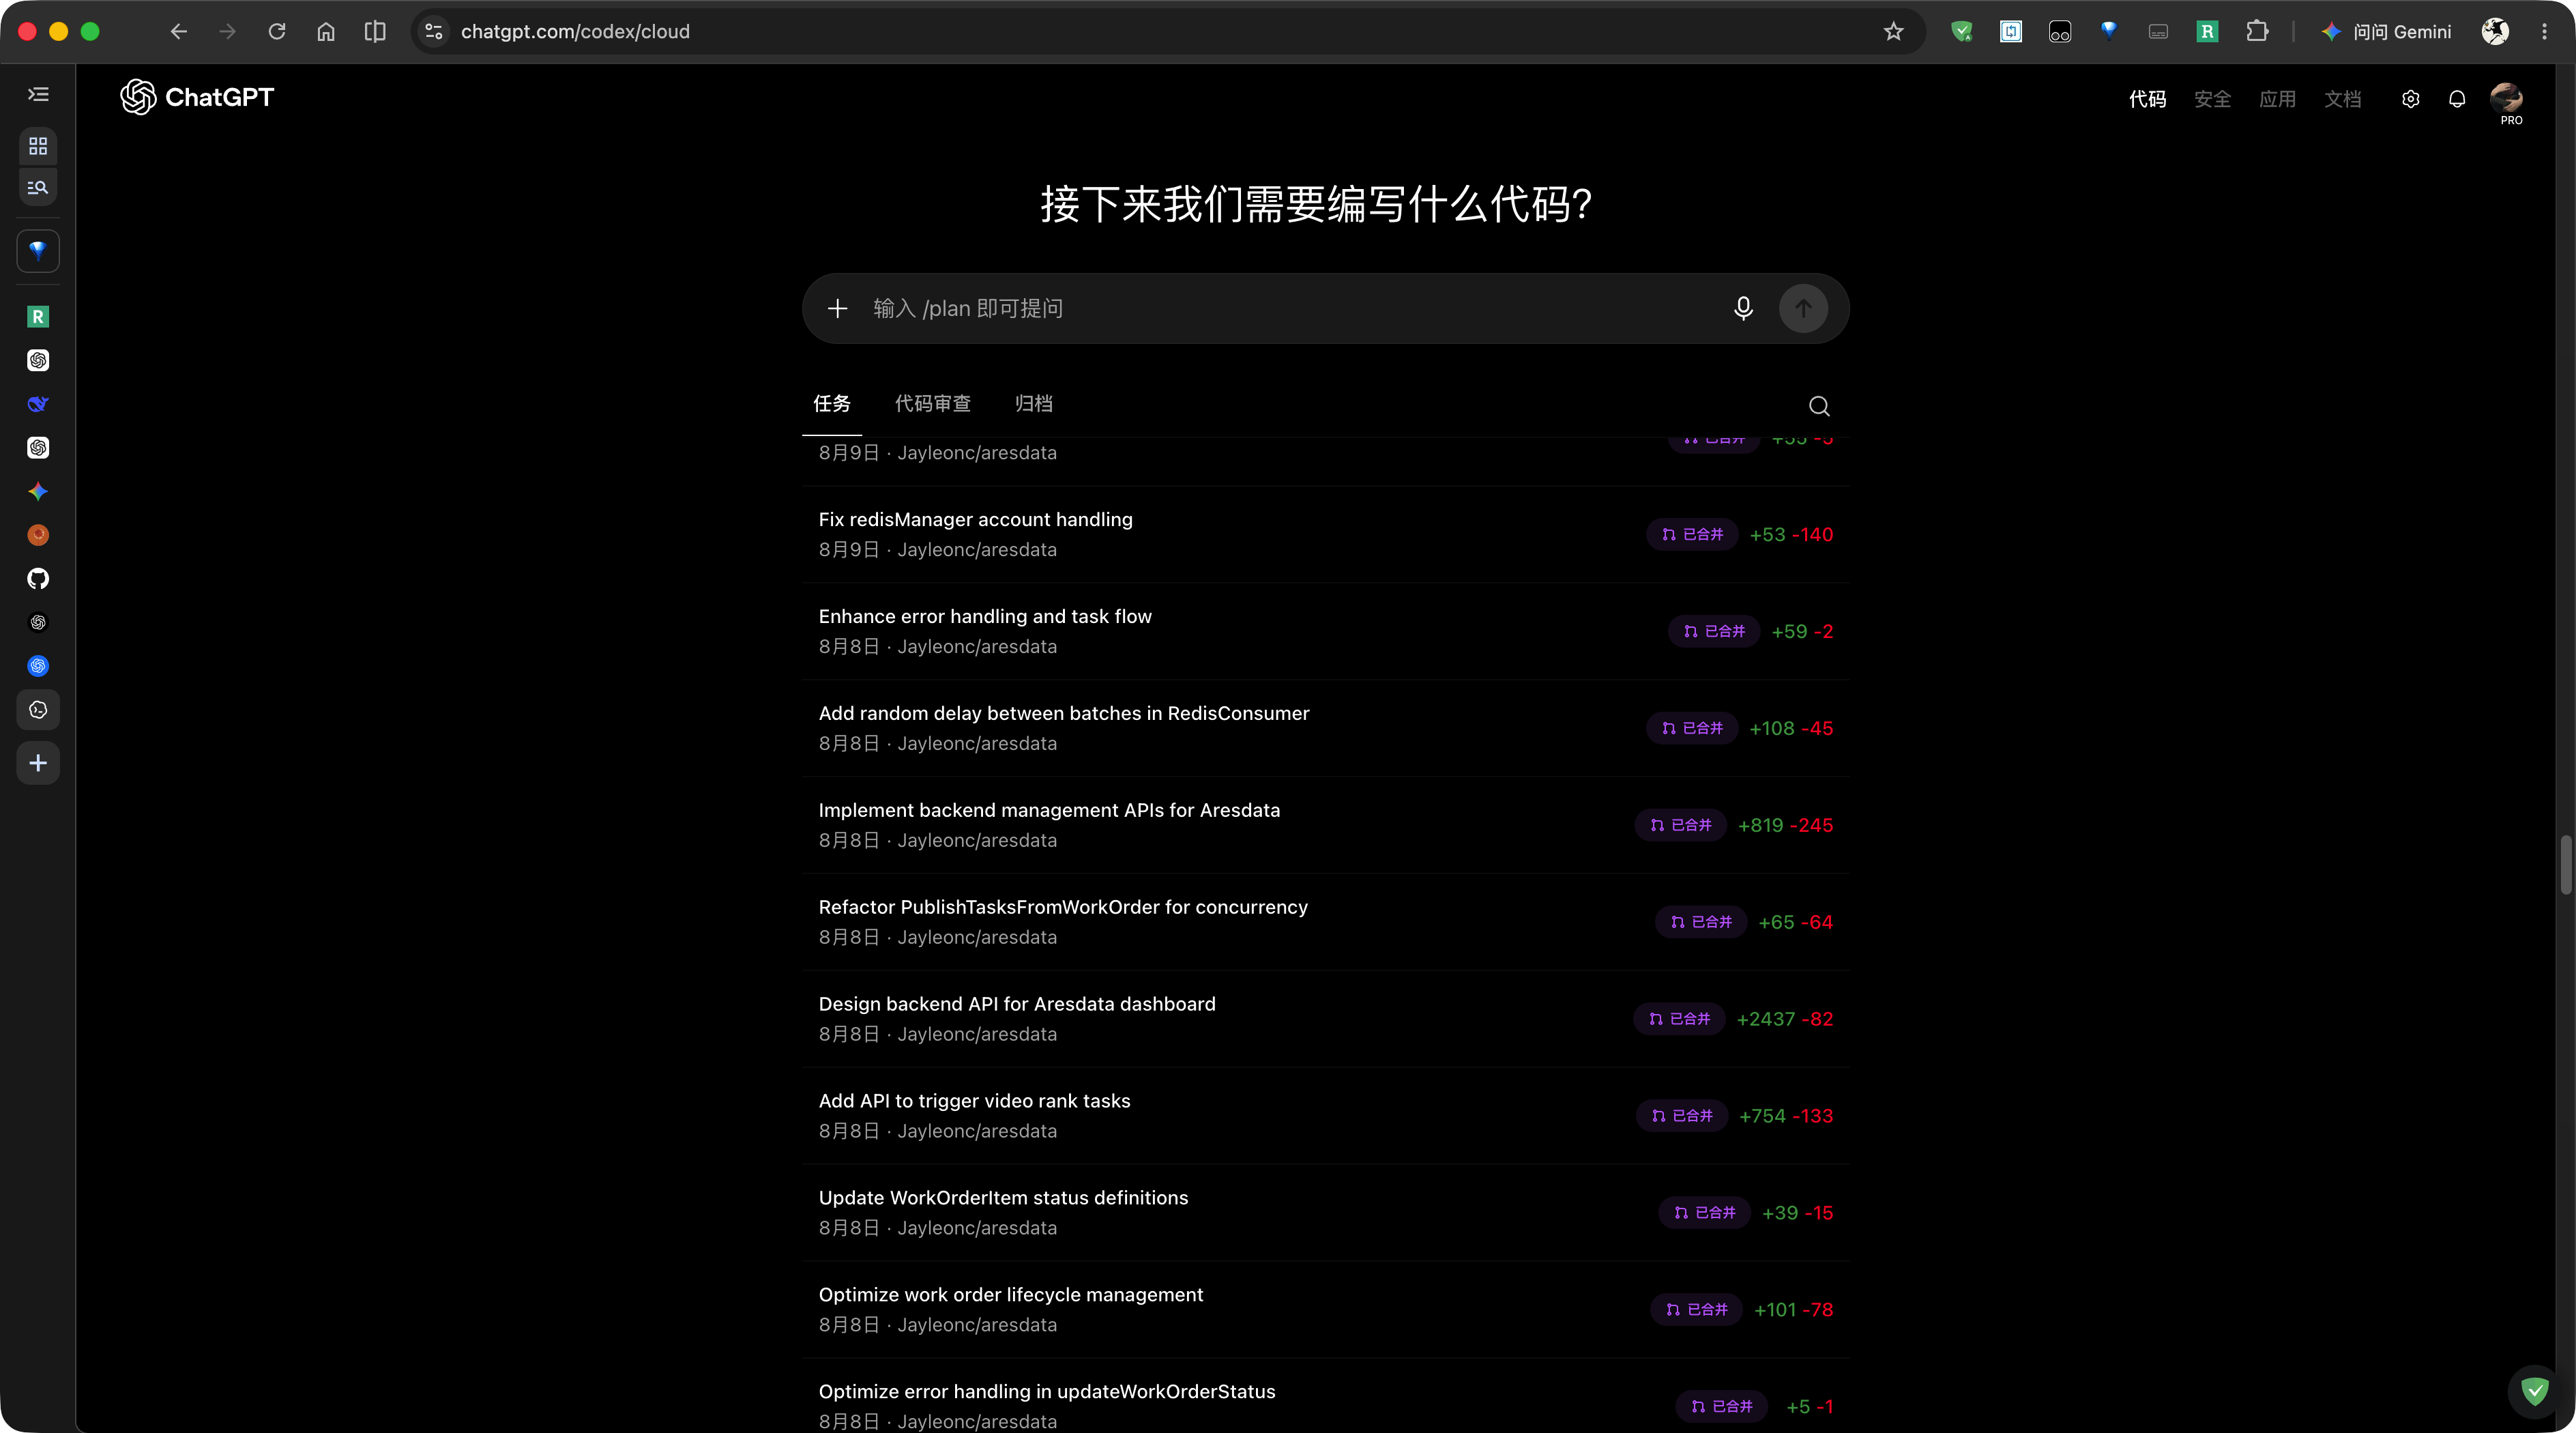
那时候主要拿它做第二个版本的智能客服,还有一些爬虫项目。回头再看挺有意思的,当时还在嫌模型慢,现在的模型已经快得离谱,写代码、跑工具,连操作电脑都不在话下。也就过去这么点时间,变化是真的快,哈哈哈。
顺便吐槽一下 A 社。我前后被封了三个号,其中一个刚通过 Apple 订阅了 Max,算上苹果税一共 124 美元,人民币八百多,结果只用了三天就被封了,有点太过分了… 反过来看 OpenAI,我现在用的同等级 Pro 是 100 美元,奥特曼都算得上良心了。
前几个月,我开始把日常开发逐步搬到 Codex。现在从代码分析、方案讨论到修改、测试和 Git 操作,基本都在同一个任务里完成。我现在甚至“懒”到部署测试都是 Codex 在工作了,还是那句话,人只需要负责思考和决策。
这次清理先整理了行为基线、能力清单和任务,再沿着真实调用链确认哪些实现仍然在工作。
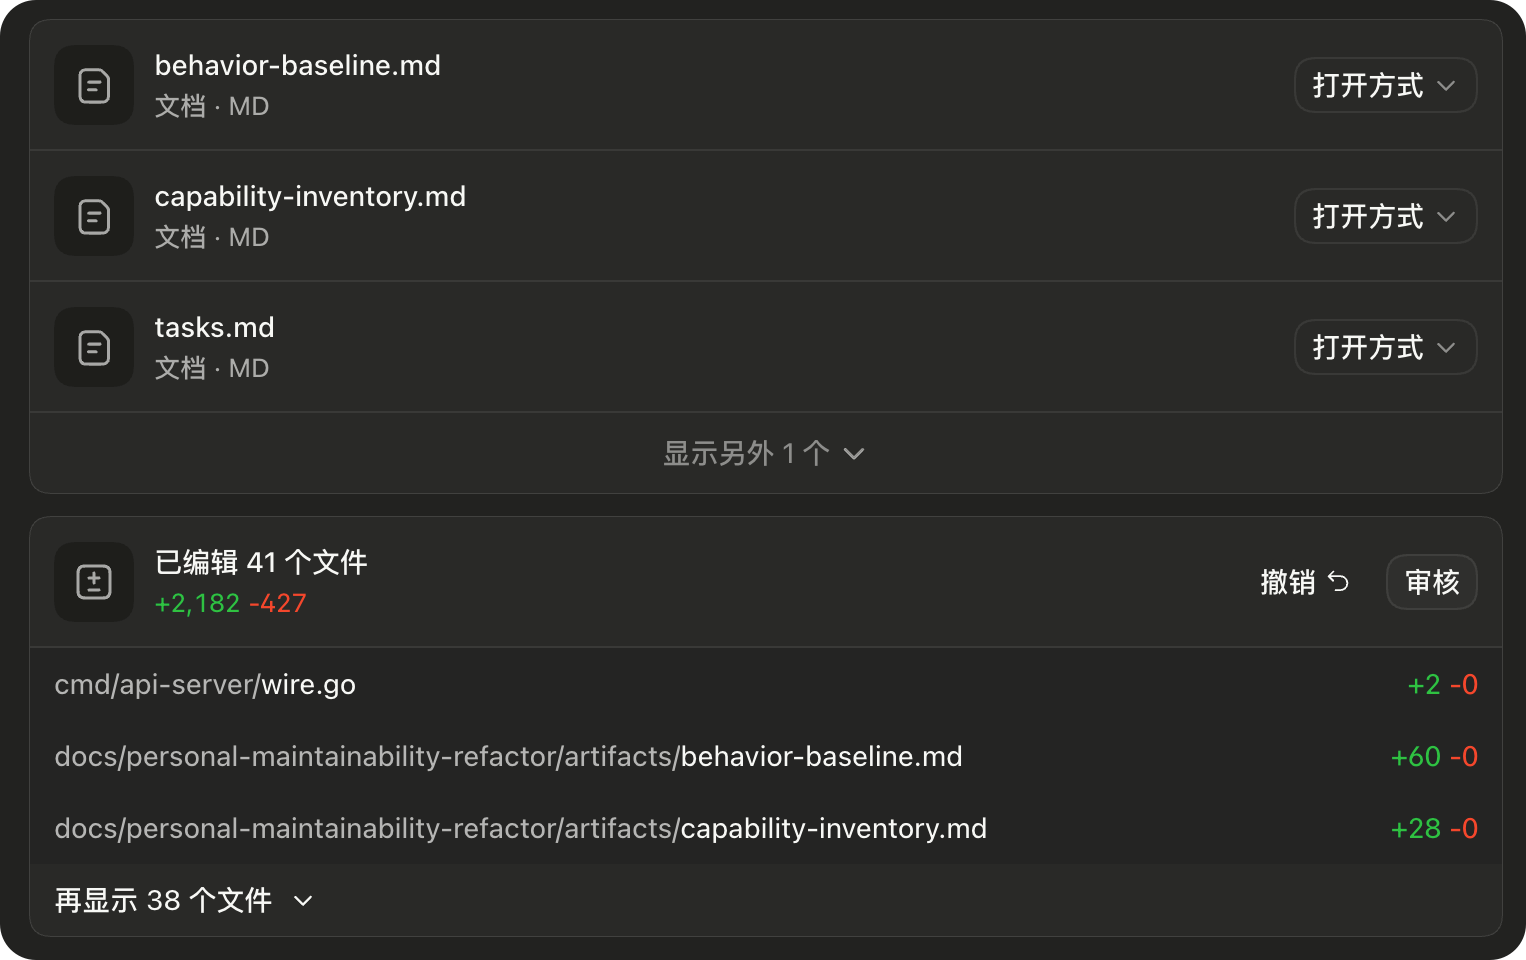
后面按照模块逐段处理。Content API 这一轮就删掉了八千多行旧内容,同时保留必要的文档和当前入口。
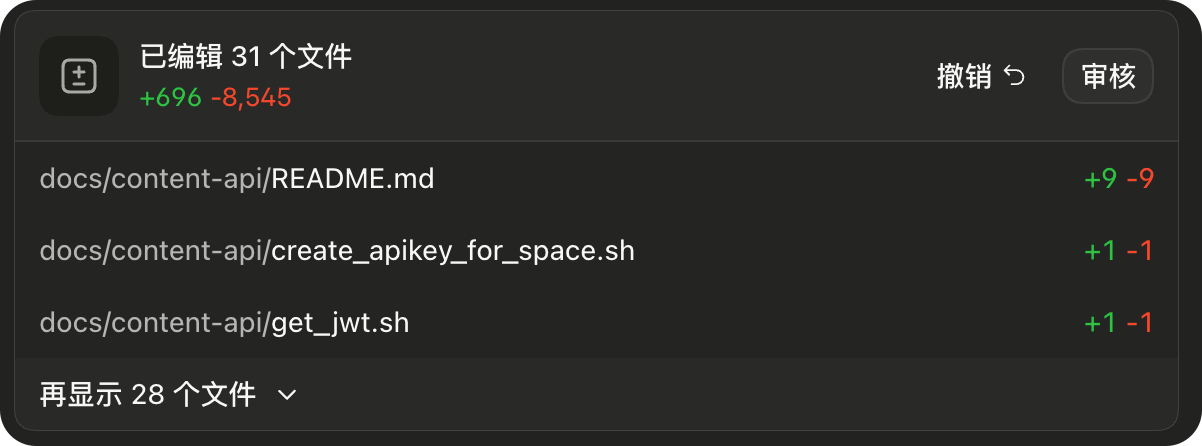
最后再把范围扩大到整个仓库,统一检查代码、文档、前端旧组件和构建产物。三张图来自不同阶段,所以图里的文件数和最终提交并不完全一样。
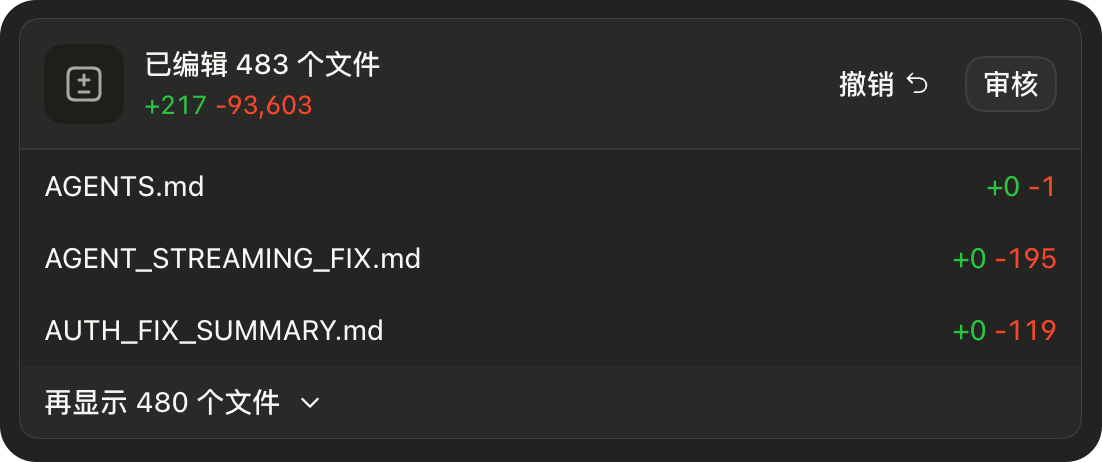
这种大范围清理很适合交给 Codex 做搜索和验证,我负责决定哪些东西还能代表当前产品,并逐项检查最终 Diff。用了几个月以后,关于为什么从 Claude Code 换到 Codex、怎么安排长任务、怎么审核大改动,其实也有不少东西可以单独写一篇分享。
接下来要不要继续追新东西
AI 这个行业变化很快,新的模型、工具和交互方式几乎隔一段时间就会换一轮。RAG 也一直在演进,新的检索方案、架构思路和算法版本会陆续出现,连 pgvector 这类底层组件的索引与查询方式也在持续更新。
至于要不要接进 KH,需要回到产品里判断。它能不能让检索效果更好,能不能让操作更简单,或者解决一个现在确实存在的问题。只因为新就接进来,过几个月大概率又要清理一次。
对 KH 来说,简单和稳定比功能数量更重要。一个人维护项目时尤其如此,每多一层框架、多一个模块,后面的维护最终还是会回到我这里。
Turnmesh 和 LangChainGo
Agent 的主循环已经放到了 Turnmesh。模型轮次、工具调用和运行时事件由 Turnmesh 负责,KH 保留会话、权限、检索和业务数据。
不过 LangChainGo 还没有完全离开。底层 Provider、消息转换、Embedding 和部分多模态路径仍然在使用它。
要不要继续移除,我还没有决定。
LangChainGo 在项目早期帮了不少忙,很多功能可以很快搭起来。业务变复杂以后,它的一些数据结构和调用方式也开始限制扩展。有时候想调整一个很小的行为,却要顺着框架处理好几层适配。
我们的习惯一直比较朴素:源码掌握在自己手里,功能简单,能够自己维护,通常用起来更放心。
这也不代表所有东西都要自己重写。成熟的库能省时间就继续用;当维护它的成本已经高于自己实现,才值得考虑替换。LangChainGo 后面怎么处理,还得结合实际调用继续看。
先把昂贵接口保护起来
相比继续拆服务,Limit 是下一件比较确定的事。
文档解析、索引、检索、Agent 执行和开放 API 都会消耗资源。现在的流量不大,很多风险暂时不会出现。使用量上来以后,一个没有限制的昂贵接口就可能拖慢整个服务。
Rate Limit、并发限制、额度和必要的管理开关都需要补上。先把现有服务保护好,再考虑下一批功能。
这次清理没有改变 API、Chat 和 Workspace 的行为。对后面的开发会有影响:再看检索调用时,不需要在两套实现之间猜;再让 AI 读文档时,也少一些已经失效的答案。
KH 最后会走成什么样子,我现在也不知道,这也没关系。
先把 Limit 补上。其他的,边用边看。